
论文「复现不了」:七成研究者栽过跟头,阴性结果为何没人发
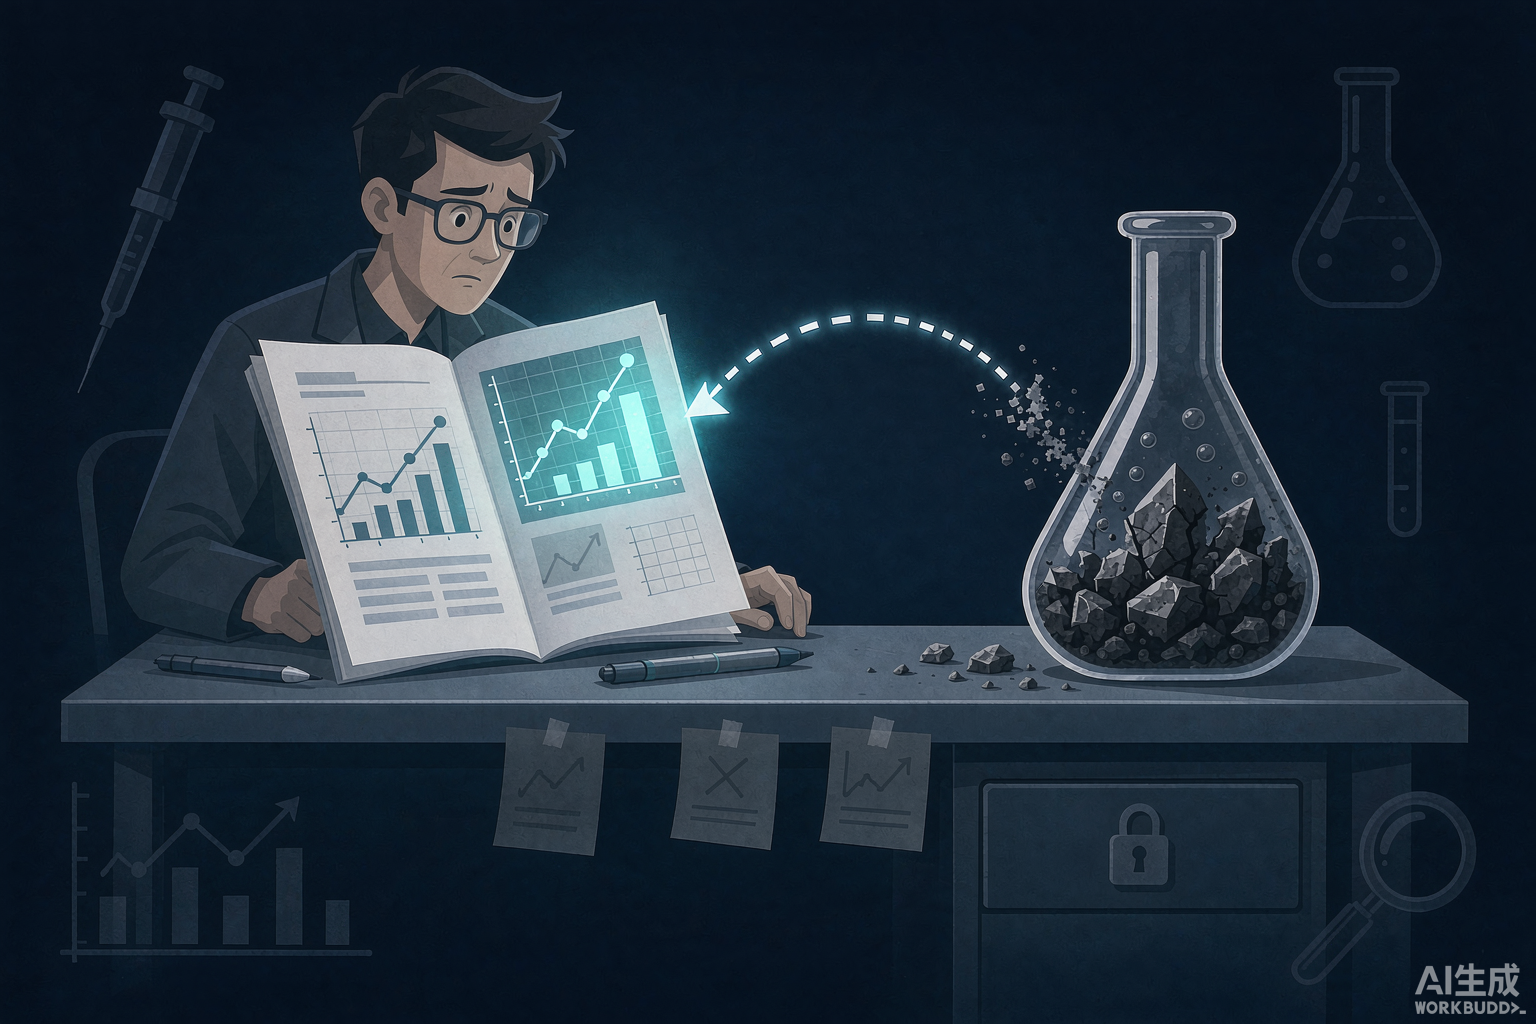
2026年1月,《科学》发表了一篇不太讨喜的论文:美国匹兹堡大学团队耗时两年,严格重复了一项曾被奉为拓扑量子计算里程碑的实验,结论是那个「重大突破」很可能只是实验参数偶然组合产生的假象。更耐人寻味的是,团队最初把这份重复验证结果投给原研究发表的同一本顶刊,被以「缺乏创新性」直接拒稿。一篇守护科研根基的论文因为「不够新」无人问津,一个可能误导领域数年的漂亮错误却曾风光无限——这不是个案,而是整套发表体系的缩影。
七成研究者复现失败
数字更不体面。《自然》的一项调查显示,超过70%的研究者曾无法复现他人实验,超过50%连自己以前的成果都重复不出来。早在2016年《自然》发起的重复验证研究中,心理学与癌症生物学领域就有超过一半的经典实验结果无法重复;但那些「无法被重复」的原始论文,至今被引次数仍远高于重复验证论文。另一组数据同样刺眼:约95%的失败数据不见天日,81%的研究者产出过阴性结果,75%的人愿意发表,最终只有12.5%的人有机会这样做。
问题不只在造假,更在「没写清楚」
很多人把可重复性危机归咎于学术不端或统计谬误,但更隐蔽、更普遍的原因是方法写得太省。「按照常规流程进行纯化」——什么是常规?温度、pH、离心转速分别是多少?只报告「有显著性差异」的比较,不提那些没有差异的尝试;原始数据写「可应要求提供」,而要求往往被忽略。这些模糊背后,不全是写作能力不足,有时是发表压力下的刻意留白:留一手独门秘技,让竞争者难以重复,为自己争取时间优势。代价却是整个学科的信任崩塌。
还有一类游走在灰色地带的做法,学界称为P值操纵:手里有一堆数据,事先没有固定假设,把变量反复排列组合、试几十种统计方式、剔除不同「异常样本」,终于凑出一组达到显著性的关系,再倒过来写成「我一开始就提出这个假设并成功验证」。全程没有篡改任何原始数字,外人粗看挑不出毛病,却制造了大量虚假关联。这类问题比蓄意造假更普遍,也更难定性,被普遍认为是复现危机最主要的推手之一。大型重复实验显示,不少已发表的社会科学研究换一批数据重测,结论就站不住脚,复现成功率大概只有一半。
为什么阴性结果天然难产
顶刊的通行证是「创新性」「颠覆性」「高影响力」,编辑、审稿人、媒体和读者都更愿意看到一个漂亮的新规律。而「我做了大量实验,证明这个假设不成立」这种工作,既没有故事,也不产生引用,连送审机会都拿不到。发表偏倚由此形成:大量证明某条路走不通的研究被锁在个人电脑文件夹里,只有找到新奇相关性的结果进入文献库。后果是连锁的——荟萃分析被阳性结果扭曲,后来者不断重复别人早已失败的实验,理论模型建立在不完整的数据上,AI模型又继承并放大这种偏差。更麻烦的是隐性知识的流失:哪些参数组合会导致模型不稳定、哪些条件根本不可行,这些经验往往只存在研究者个人记忆里,人一走就归零。
把「可复现」做成可操作的动作
第一,方法部分按「陌生人能照做」的标准写:试剂供应商与纯度、仪器型号与参数、样本量计算依据、排除标准、失败尝试,全部留痕,别用「常规」「适当」这类词。第二,尽可能预注册假设与分析方案,把探索性分析和验证性分析分开标注,避免事后假设被包装成先验假设。第三,数据与代码按FAIR原则存放到可长期访问的仓库,标注版本、依赖环境和元数据;纸质记录本手抄易错、版本混乱,据统计超过50%的实验室因纸质记录面临数据丢失风险,年均流失率约17%,这一步值得投入。第四,主动给阴性结果找出口:注册报告(Registered Reports)、专门收录阴性结果的期刊与数据论文、课题组的内部失败案例库,都能把「此路不通」变成公共知识。第五,引用与评价时别只盯影响因子,把方法透明度、数据与代码可用性纳入判断——评价指挥棒不动,前面四条很难坚持。
开放科学正在补漏洞
值得欣慰的是方向已经变了:研究预注册、鼓励复制研究、开放数据与代码、专业统计审查,这些「开放科学」实践正在重塑科研的底层逻辑;国内破四唯改革、基金申请中引入数据共享激励,也在从制度端纠偏。回到匹兹堡大学那篇论文,它最终被《科学》接收,靠的不是炫酷方法,而是把每一个实验参数的来源、调整过程、甚至失败的尝试都写得足够清楚。科学并不能自动纠错,能让它变可靠的,是一代代人愿意把「不好看的事实」也认真记下来。
本文由 RDLink研发家(www.yanfajia.com)整理发布。我们关注科研方法与学术生态的长期健康,持续分享能直接用在实验台前的实务建议。
赞一个



更有众多热门